CSVインポート
Kanera は、固定列レイアウトを必要とせずに、CSV エクスポートまたはスプレッドシートをカードに変換できます。すべての列の意味を確認し、何かを作成する前に、Kanera が見つけたリスト、ラベル、カスタム フィールド、およびメンバーをマッピングします。
- で ワークスペースをインポートすると、新しいボードが作成され、CSV データがワークスペースの共有リストとカスタム フィールドにマップされます。
- で 独立ボードをインポートすると、そのボードにカードが追加され、既存のカード、名前、外観、権限は変更されません。
始める前に
宛先ワークスペースまたはスタンドアロン ボードへの管理者アクセス権と、20 MB 以下の CSV ファイルが必要です。
インポートには、最大 20,000 のデータ行と 200 の列を含めることができます。 Kanera は、カンマ、セミコロン、タブ、パイプで区切られたファイルを受け入れます。 UTF-8 および UTF-16 ファイルを読み取り、古いエクスポートの場合は Windows-1252 にフォールバックできます。
最もきれいな結果を得るには、ヘッダー行を 1 つ、各行に 1 つのカードを残します。共有値をマッピングすることで、繰り返される行を 1 つのカードに結合することもできます。 カードID/グループ.
CSVインポートを開く
- 宛先のワークスペースまたはスタンドアロン ボードを開きます。
- に行く ワークスペースの設定 または ボードの設定.
- 開く インポート.
- 選択してください CSV.
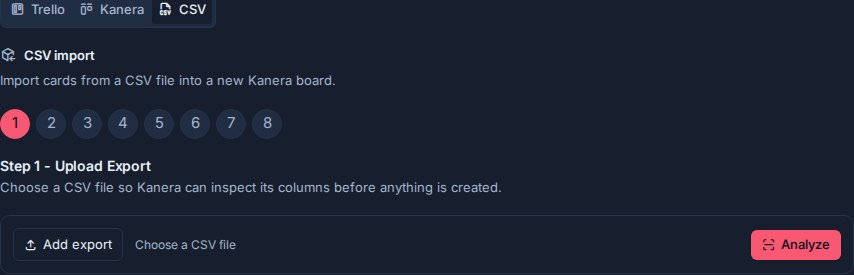
ステップ 1: アップロードして分析する
CSV ファイルを選択またはドロップし、 分析する。 Kanera はファイルのエンコードと区切り文字を検出し、プレビューを読み取り、タイトル、ステータス、ラベル、担当者、期限、説明などの一般的な見出しからのマッピングを提案します。
空白行は無視されます。行のセルがヘッダーよりも少ない場合、Kanera はデータを間違った列に移動するのではなく、その行を埋め込み、プレビューで問題を報告します。
ステップ 2: 列をマップする
最初の行に見出しが含まれているかどうかを確認し、ちょうど 1 つの列を タイトル。他のすべてのマッピングはオプションです。
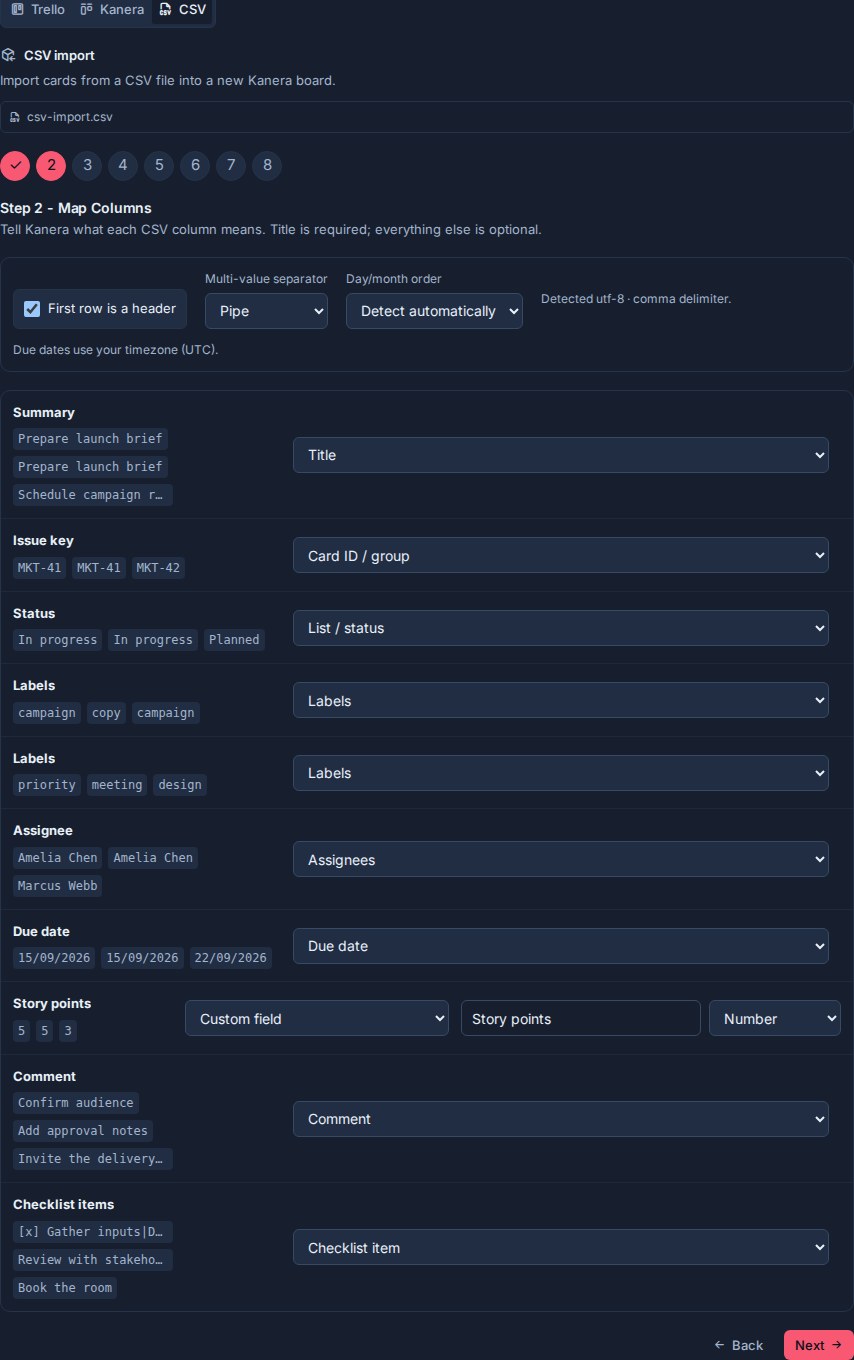
| 列ターゲット | Kaneraが生み出すもの |
|---|---|
| タイトル | カードのタイトル。 Title 列は 1 つだけ必要です。 |
| 説明 | カードの説明。 |
| 一覧・ステータス | 次のステップで作成、マッピング、またはスキップできるソース リスト。 |
| 期限 | 日付限定のKanera期限。 |
| 完了しました | 完成したカードの状態。 |
| アーカイブ済み | アーカイブされたカードの状態。 |
| で作成されました | 値を解析できる元のカードの作成時間。 |
| カードID/グループ | 同じ空ではない ID を持つ行を 1 つのカードに結合します。 |
| ラベル | 1 つ以上のラベル。 |
| 譲受人 | Kanera ユーザーにマップする 1 人以上のユーザー。 |
| コメント | インポートを実行した人による 1 つ以上のコメント。 |
| チェックリスト項目 | インポートされたチェックリスト内の 1 つ以上の項目。 |
| カスタムフィールド | テキスト、数値、チェックボックス、選択、日付、または URL フィールド。 |
| 無視する | 列をインポートから除外します。 |
繰り返される見出しは別の列のままになります。これは、いくつかの情報を含む Jira CSV ファイルなどのエクスポートに便利です。 ラベル または コメント 列: 繰り返される各列を同じ複数値ターゲットにマップすると、Kanera はそれらの値を累積します。
複数値のセル内で使用する区切り文字 (カンマ、セミコロン、パイプ、または改行) を選択します。
複数の行を 1 つのカードにグループ化する
安定した課題キーまたはタスク ID をマッピングする カードID/グループ 1つのカードが複数行にまたがる場合です。同じ空でないIDの行は1枚のカードになります。単一値のプロパティは最初の行から取得し、ラベル、担当者、コメント、チェックリスト項目は同じグループの行と繰り返しマッピングされた列から集めます。
グループ列がないと、すべてのデータ行が個別のカードになります。
日付とタイムゾーン
Kanera は ISO の日付とタイムスタンプを認識します。 YYYY/MM/DD, YYYY.MM.DD、数値日付、名前付き月、Jira スタイルの日付など 01/Jan/25 1:30 pm、Excel のシリアル日付。
次のような値の場合、 01/02/2025 2 月 1 日または 1 月 2 日のいずれかを意味します。選択してください 日/月/年 または 月/日/年 続ける前に。変動日付では、ブラウザーに表示されるタイムゾーンが使用されます。期日は、日付のみのいつでも期日としてインポートされます。ソース時刻は保持されません。
ステップ 3 ~ 6: 宛先を確認する
列のマッピング後、ウィザードは Trello およびKanera アーカイブ インポーターと同じレビュー フローを使用します。
- ソースリストを作成、マッピング、またはスキップします。
- ラベルを作成、マッピング、またはスキップします。
- カスタム フィールドと選択フィールド オプションを作成、マッピング、またはスキップします。
- ソース担当者をアクセス権のあるユーザーにマップするか、未割り当てのままにします。
- 新しいボード名とインポートの概要を確認し、確認します。
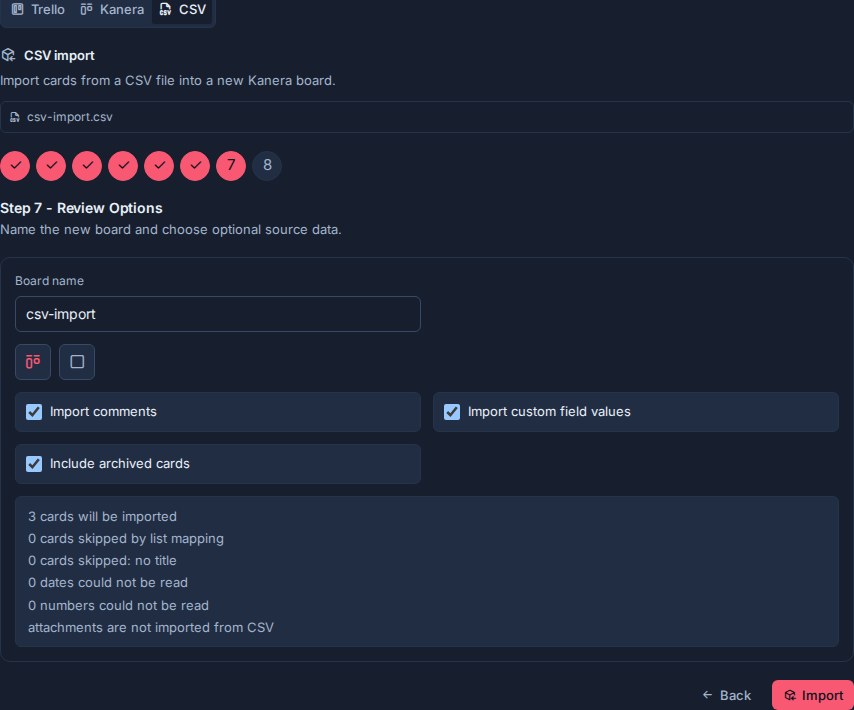
レビューでは、タイトルのない行、読み取れなかった日付、無効な数値が報告されます。タイトルのない行はスキップされます。無効なオプション値は、すべての有効な行をブロックするのではなく、カードから除外されます。
インポートされるもの
CSV では、カードのタイトル、説明、リストの配置、期日、完了およびアーカイブされた状態、作成日、ラベル、マップされた担当者、コメント、チェックリスト項目、サポートされているカスタム フィールド値をインポートできます。
CSV インポートには、添付ファイル、優先度、開始日、元のコメントの作成者は含まれません。使用する Trello インポート 代わりに、Trello から移行し、添付ファイルのリンクまたはアップロードされたファイルをKanera にコピーする必要がある場合に使用します。
カードはターゲット リストの最後に追加され、宛先のワークスペースまたはスタンドアロン ボードから新しいキーを受け取ります。
ソースエクスポートのヒント
- ジラ: 概要、課題キー、ステータス、ラベル、担当者、期日、コメント、および必要なカスタム フィールドが含まれます。課題キーを次の場所にマップします カードID/グループ エクスポートで複数の行にわたって問題が繰り返される場合。
- アサナ: 名前をマップする タイトル、セクションまたは列へ 一覧・ステータス、および譲受人 譲受人.
- トレロ: 添付ファイルが重要ならTrello JSONを使ってください。カードだけの簡単な移行にはCSVが適しています。
- スプレッドシート: 繰り返される行が意図的にグループ ID を共有しない限り、1 つのヘッダー行と 1 つの行ごとに 1 つのカードを保持します。
インポートは 1 回限りのコピーです。後でソース システムまたはスプレッドシートに加えられた変更は、Kanera に同期されません。